Domain monumentalfilme.de kaufen?
Wir ziehen mit dem Projekt
monumentalfilme.de um.
Sind Sie am Kauf der Domain
monumentalfilme.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain monumentalfilme.de kaufen?
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **

Ähnliche Suchbegriffe für Datenquellen
Top-Angebote
Produkte zum Begriff Datenquellen:
-
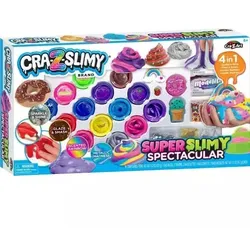
Cra-Z-Slimy Super Schleim SpektakelLernen Sie das Cra-Z-Slimy Super Slimy Spectacular-Set kennen, das jedem Kind ein aufregendes Schleim-Erlebnis garantiert! Dieses 4-in-1-Set bietet zahlreiche spezielle Schleimvarianten: Metallisch, glitzernd, duftend und glänzend. Das Paket enthält außerdem weiches Modelite-Modelliermaterial, Anhänger, Glitzer und geformte Aufbewahrungsbehälter, mit denen die Kinder kreativ experimentieren können. Beim Spielen können die Kinder ihre Kreativität und Feinmotorik entwickeln, während sie die besonderen Texturen und das beeindruckende Aussehen des Schleims genießen. Die Kombination verschiedener Farben und Materialien bietet eine großartige Möglichkeit zur Herstellung individueller Kreationen. Produkteigenschaften: 4 verschiedene Schleime: metallisch, glitzernd, duftend, glänzend Weiches Modelite-Modelliermaterial Bunte Anhänger und Glitzer Besondere geformte Aufbewahrungsbehälter Entwicklung von Kreativität und Feinmotorik Verpackungsgröße: 30,5 x 55,9 x 6,4 cm Das Cra-Z-Slimy Super Slimy Spectacular ist die ideale Wahl für alle kreativen Kinder, die gerne die Welt des Schleims entdecken.27,39 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter


-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Datenquellen:
-
12er-Probierpaket »Italien-Blockbuster«Italien, dunkelrot gelesen. Italienische Rotweine passen in keine einzige Schublade. Zwischen den sonnenwarmen Weinbergen Apuliens, den Hügellagen der Toskana, den Böden Siziliens und der Weinlandschaft rund um Rom entstehen ganz unterschiedliche Charaktere. Dieses Paket bringt diese Vielfalt zusammen und zeigt, wie facettenreich Italiens rote Seite sein kann.Im Mittelpunkt stehen drei Primitivo aus Apulien, die ihre Herkunft jeweils anders interpretieren. Der Leonetti Primitivo »Regulus« wirkt elegant und schmelzig, mit reifen Beeren, Kirschen und feiner Würze. Der Oroscuro Primitivo di Manduria setzt auf konzentrierte dunkle Frucht, weiche Tannine und samtige Fülle. Der Dolce Sera Primitivo di Manduria ergänzt das Trio mit saftiger Frucht, dezenter Süße und einer besonders zugänglichen Art.Der Marchese Mezzo Chianti Classico führt in die Toskana und bringt mit Sangiovese, feinen Tanninen und würziger Frucht die klassische Seite Italiens ins Glas. Aus Sizilien kommt der biologisch erzeugte Burgio Millusio Nero d’Avola Syrah. Die Verbindung aus Nero d’Avola und Syrah sorgt für Sauerkirschen, Pflaumen, Himbeeren und eine geschmeidige, vollmundige Struktur.Der Federici Roma Rosso »Edizione di Famiglia« beschließt die Auswahl mit einer harmonischen Cuvée aus Montepulciano und Sangiovese. Reife rote Früchte, Kirschen, Kräuter und feine Würze machen ihn zu einem vielseitigen Vertreter der römischen Weinlandschaft.Was die Weine verbindet, ist ihre italienische Herkunft und die Freude an Rotweinen, die Frucht, Würze und mediterrane Wärme miteinander verbinden – jeder auf seine eigene Weise.79,90 €*Versand: 2,89 €Sichere Weiterleitung zum Anbieter
-
Cra-Z-Slimy Super Schleim SpektakelLernen Sie das Cra-Z-Slimy Super Slimy Spectacular-Set kennen, das jedem Kind ein aufregendes Schleim-Erlebnis garantiert! Dieses 4-in-1-Set bietet zahlreiche spezielle Schleimvarianten: Metallisch, glitzernd, duftend und glänzend. Das Paket enthält außerdem weiches Modelite-Modelliermaterial, Anhänger, Glitzer und geformte Aufbewahrungsbehälter, mit denen die Kinder kreativ experimentieren können. Beim Spielen können die Kinder ihre Kreativität und Feinmotorik entwickeln, während sie die besonderen Texturen und das beeindruckende Aussehen des Schleims genießen. Die Kombination verschiedener Farben und Materialien bietet eine großartige Möglichkeit zur Herstellung individueller Kreationen. Produkteigenschaften: 4 verschiedene Schleime: metallisch, glitzernd, duftend, glänzend Weiches Modelite-Modelliermaterial Bunte Anhänger und Glitzer Besondere geformte Aufbewahrungsbehälter Entwicklung von Kreativität und Feinmotorik Verpackungsgröße: 30,5 x 55,9 x 6,4 cm Das Cra-Z-Slimy Super Slimy Spectacular ist die ideale Wahl für alle kreativen Kinder, die gerne die Welt des Schleims entdecken.27,39 €*Versand: 5,99 €Sichere Weiterleitung zum Anbieter
-
Wie können Informationen effizient aus unstrukturierten Datenquellen extrahiert werden?
Durch den Einsatz von Text Mining und Natural Language Processing Technologien können unstrukturierte Daten analysiert und strukturiert werden. Algorithmen wie Machine Learning können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen. Zudem können spezielle Tools und Softwarelösungen wie Data Mining Software oder Business Intelligence Plattformen eingesetzt werden, um die Extraktion von Informationen zu automatisieren und zu optimieren. **
-
Welche Datenquellen werden zur Bereitstellung von aktuellen Straßeninformationen genutzt?
Zur Bereitstellung von aktuellen Straßeninformationen werden Datenquellen wie GPS-Daten von Fahrzeugen, Verkehrsüberwachungskameras und Sensoren an Straßeninfrastruktur genutzt. Zudem werden auch Daten von Verkehrsinformationsdiensten, Navigationssystemen und Mobilfunkanbietern herangezogen. Die Kombination dieser verschiedenen Datenquellen ermöglicht eine umfassende und aktuelle Darstellung des Straßenzustands. **
-
Was sind mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen?
Mögliche Ursachen für Inkongruenzen zwischen verschiedenen Datenquellen können unterschiedliche Datenformate, fehlerhafte Datenübertragung oder -verarbeitung sowie Inkonsistenzen in den Datenquellen selbst sein. Diese Inkongruenzen können auch durch menschliche Fehler, veraltete Daten oder unvollständige Datensätze verursacht werden. Um Inkongruenzen zu vermeiden, ist es wichtig, Datenquellen regelmäßig zu überprüfen, Datenstandards zu definieren und Datenintegrationstechnologien zu verwenden. **
-
Was sind die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen?
Die häufigsten Ursachen für Diskrepanzen zwischen verschiedenen Datenquellen sind Inkonsistenzen in der Datenerfassung, unterschiedliche Datenformate und -strukturen sowie menschliche Fehler bei der Datenübertragung. Diese Diskrepanzen können zu falschen Analysen und Entscheidungen führen. **
Ähnliche Suchbegriffe für Datenquellen
-
Wie werden Einkommensstatistiken erstellt und welche Datenquellen werden dafür verwendet?
Einkommensstatistiken werden in der Regel von staatlichen Behörden oder Statistikämtern erstellt. Zur Datenerhebung werden verschiedene Quellen genutzt, wie z.B. Steuererklärungen, Sozialversicherungsdaten, Umfragen oder administrative Daten von Unternehmen. Die gesammelten Daten werden analysiert und aufbereitet, um Informationen über Einkommen und Einkommensverteilung in der Bevölkerung zu liefern. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.